
如何把 ChatGPT 中的 LaTeX 和数学公式完整保存到 Obsidian
如果你经常用 ChatGPT 学习数学、机器学习、统计、物理、工程,或者整理技术笔记,公式通常和文字解释一样重要。
但把这些对话导出为 Markdown 时,数学公式很容易出现问题。
同一个公式在 ChatGPT 中显示正常,导出后却可能出现 LaTeX 命令损坏、反斜杠丢失,或者数学分隔符无法被 Obsidian 识别。
这次 ChatGPT to Obsidian 更新,重点解决的就是这个问题。
导出时会保留 LaTeX 和数学表达式,并将它们转换为 Obsidian 兼容的 Markdown。下载后的笔记可以直接在 Obsidian 中正确显示公式。
为什么数学公式会在导出时损坏
ChatGPT 的回答可能包含这样的损失函数:
L(w,b)=\frac{1}{n}\sum_{i=1}^{n}\left(y_i-(wx_i+b)\right)^2也可能包含梯度下降更新公式:
\theta_{t+1}
=
\theta_t
-
\eta\nabla_{\theta}L(\theta_t)
在 ChatGPT 界面中,这些内容会被渲染为格式化的数学公式。
问题通常发生在处理底层对话数据时。
LaTeX 大量依赖反斜杠:
\theta
\nabla
\beta
\rho
\frac
\mathbf
\top
其中一些字符组合与编程中的转义序列非常相似:
\n
\t
\r
\b
如果 JSON 响应已经被解析,导出流程却再次尝试解码文本,有效的 LaTeX 命令就可能被破坏。
例如:
\nabla必须继续作为 LaTeX 命令 \nabla 保留。
它不能被解释成一个换行符 \n,再加上后面的 abla。
在包含技术内容的 ChatGPT 对话中,这个区别非常关键。
ChatGPT to Obsidian 新增了哪些 LaTeX 支持
ChatGPT to Obsidian 现在会在 Markdown 导出过程中更谨慎地处理数学内容。
它会保留原始 LaTeX 命令,同时把 ChatGPT 使用的数学分隔符,转换为 Obsidian 更容易识别的形式。
ChatGPT 通常用下面的格式表示行内公式:
\( ... \)用下面的格式表示独立公式:
\[ ... \]导出时,它们会分别转换为:
$ ... $以及:
$$
...
$$
这些是 Obsidian 可以通过内置 MathJax 支持直接渲染的 Markdown 数学分隔符。
从 ChatGPT 导出到 Obsidian 的实际效果
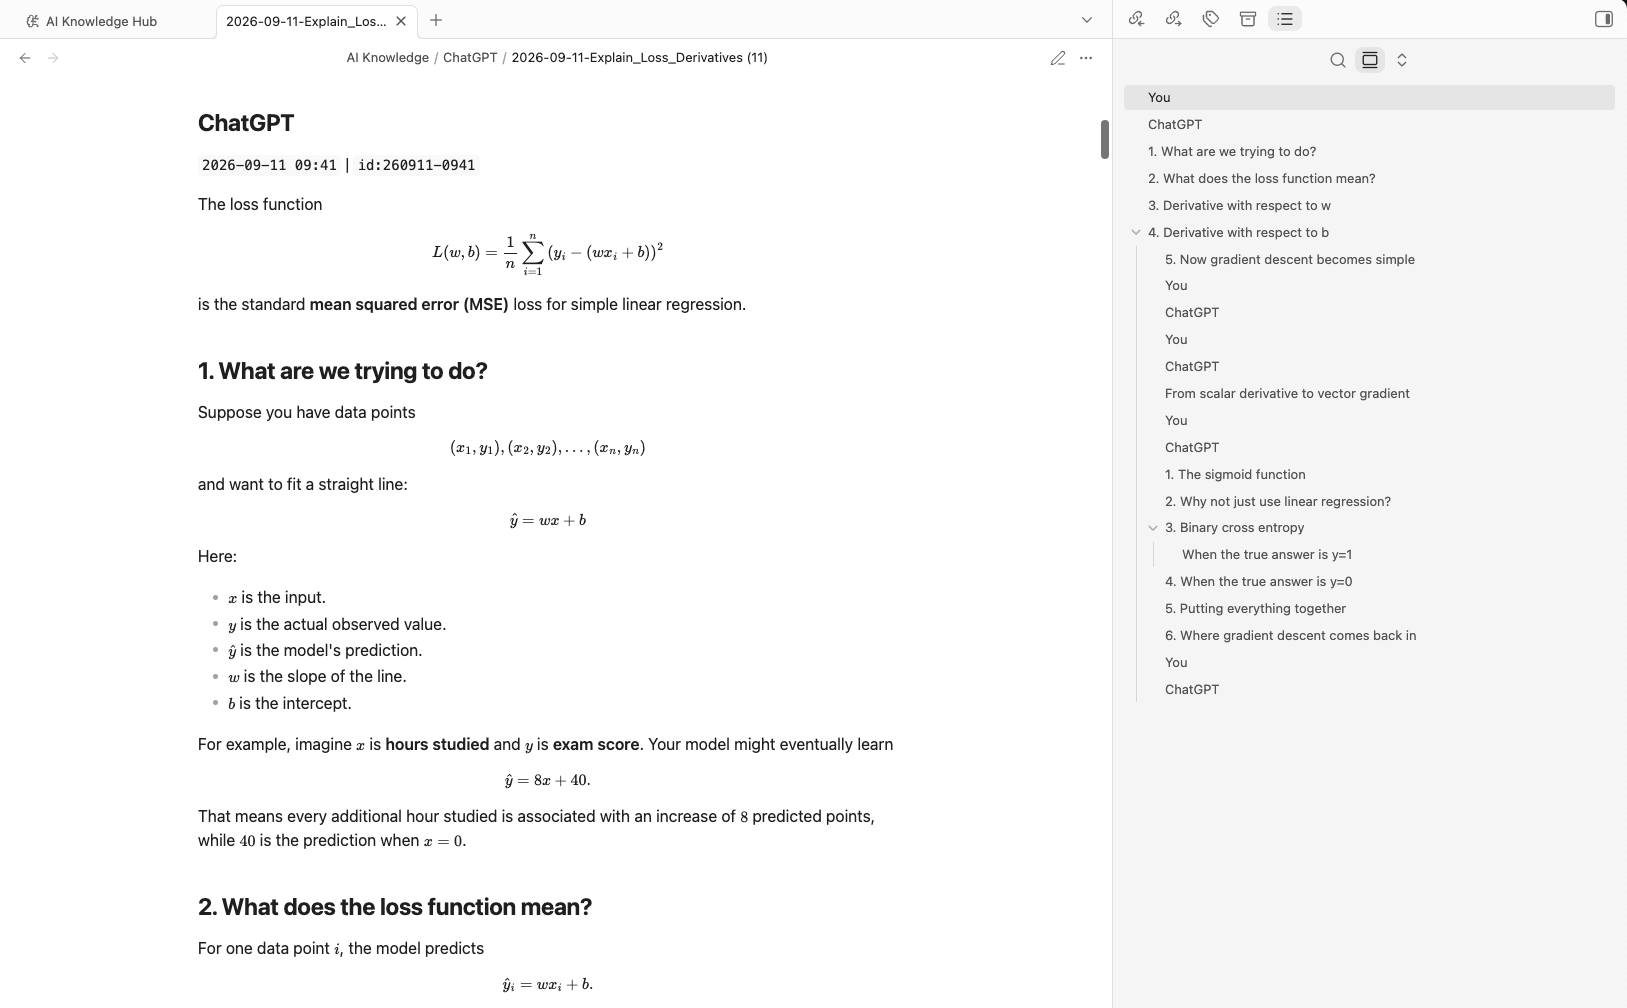
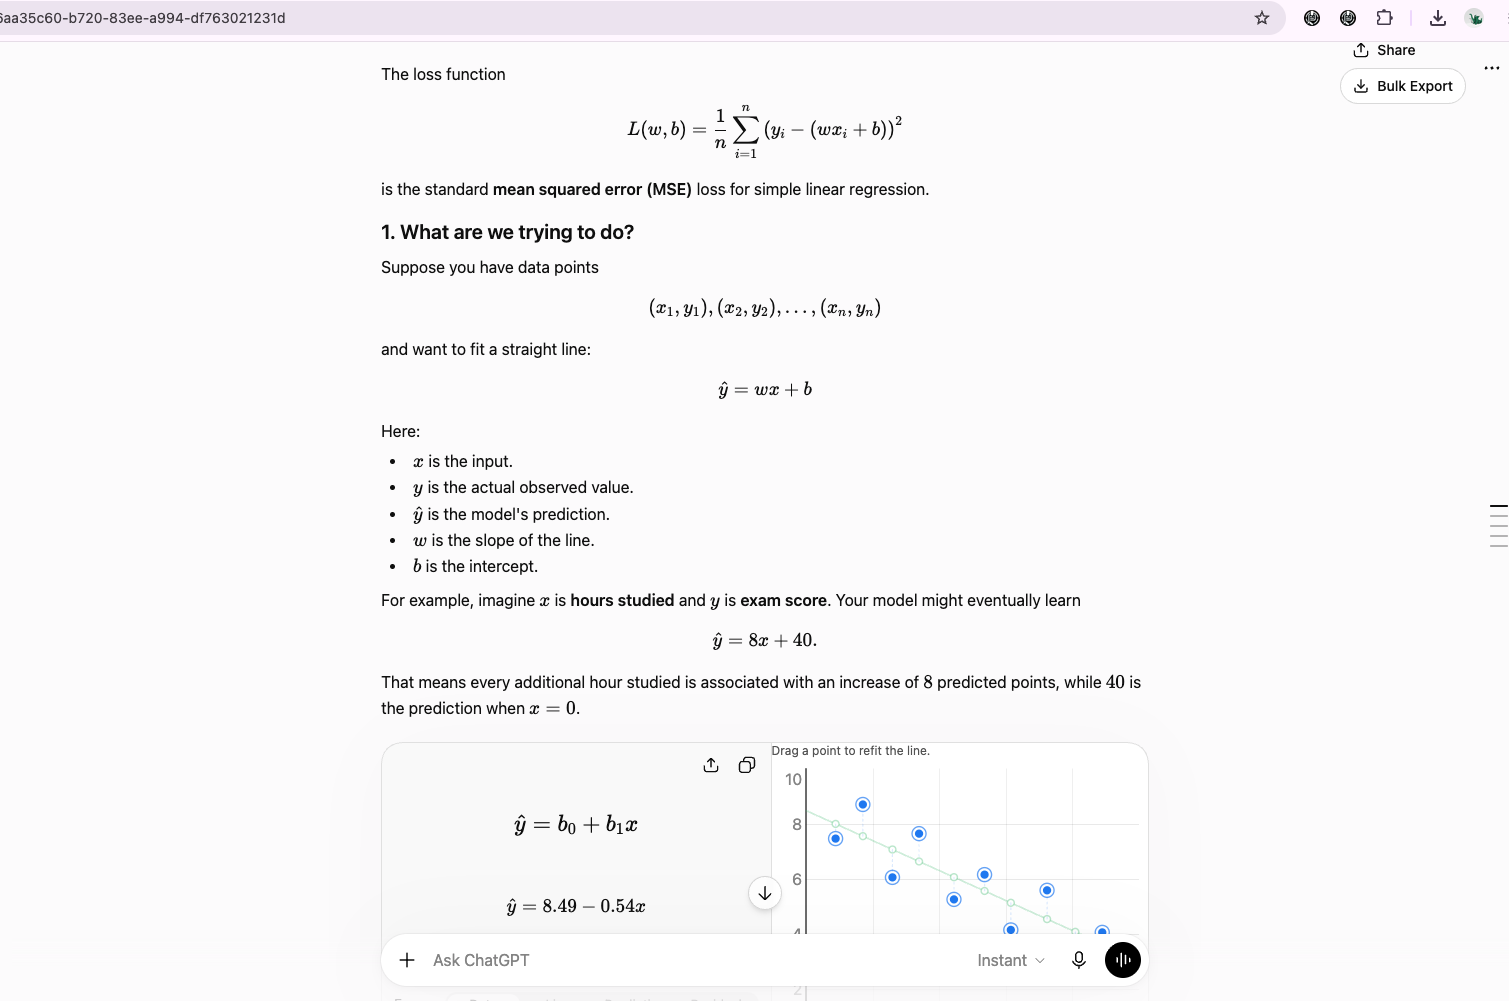
下面是一段在 ChatGPT 中正常显示的技术对话。
使用 ChatGPT to Obsidian 导出后,下载的 Markdown 文件在 Obsidian 中也能正确显示相同公式。
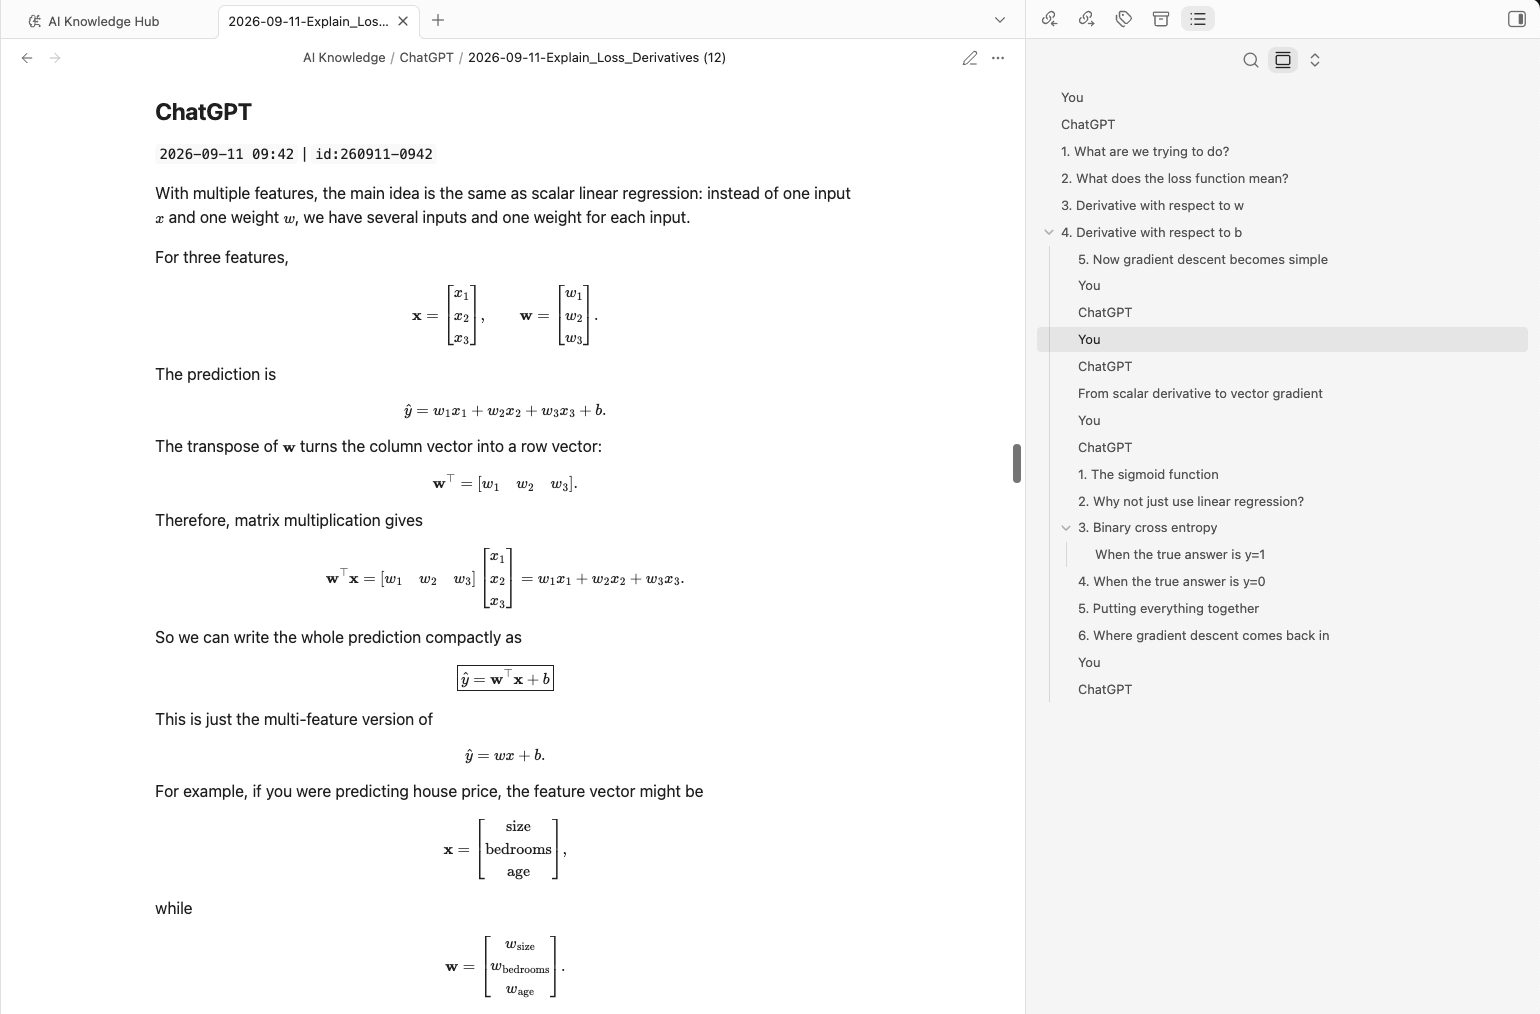
这里并没有把公式转换成截图。
公式仍然以数学文本的形式保存在 Markdown 文件中,因此可以编辑、搜索、迁移和重复使用。
不只支持简单公式,也支持矩阵和向量
这次更新并不只处理下面这样的简单表达式:
\hat{y}=wx+b它也能保留更复杂的技术符号。
例如,ChatGPT 对话中可能包含特征向量:
\mathbf{x}
=
\begin{bmatrix}
x_1 \\
x_2 \\
x_3
\end{bmatrix}
以及权重向量:
\mathbf{w}
=
\begin{bmatrix}
w_1 \\
w_2 \\
w_3
\end{bmatrix}
还可能包含矩阵乘法:
\mathbf{w}^{\top}\mathbf{x}
=
[w_1\quad w_2\quad w_3]
\begin{bmatrix}
x_1 \\
x_2 \\
x_3
\end{bmatrix}
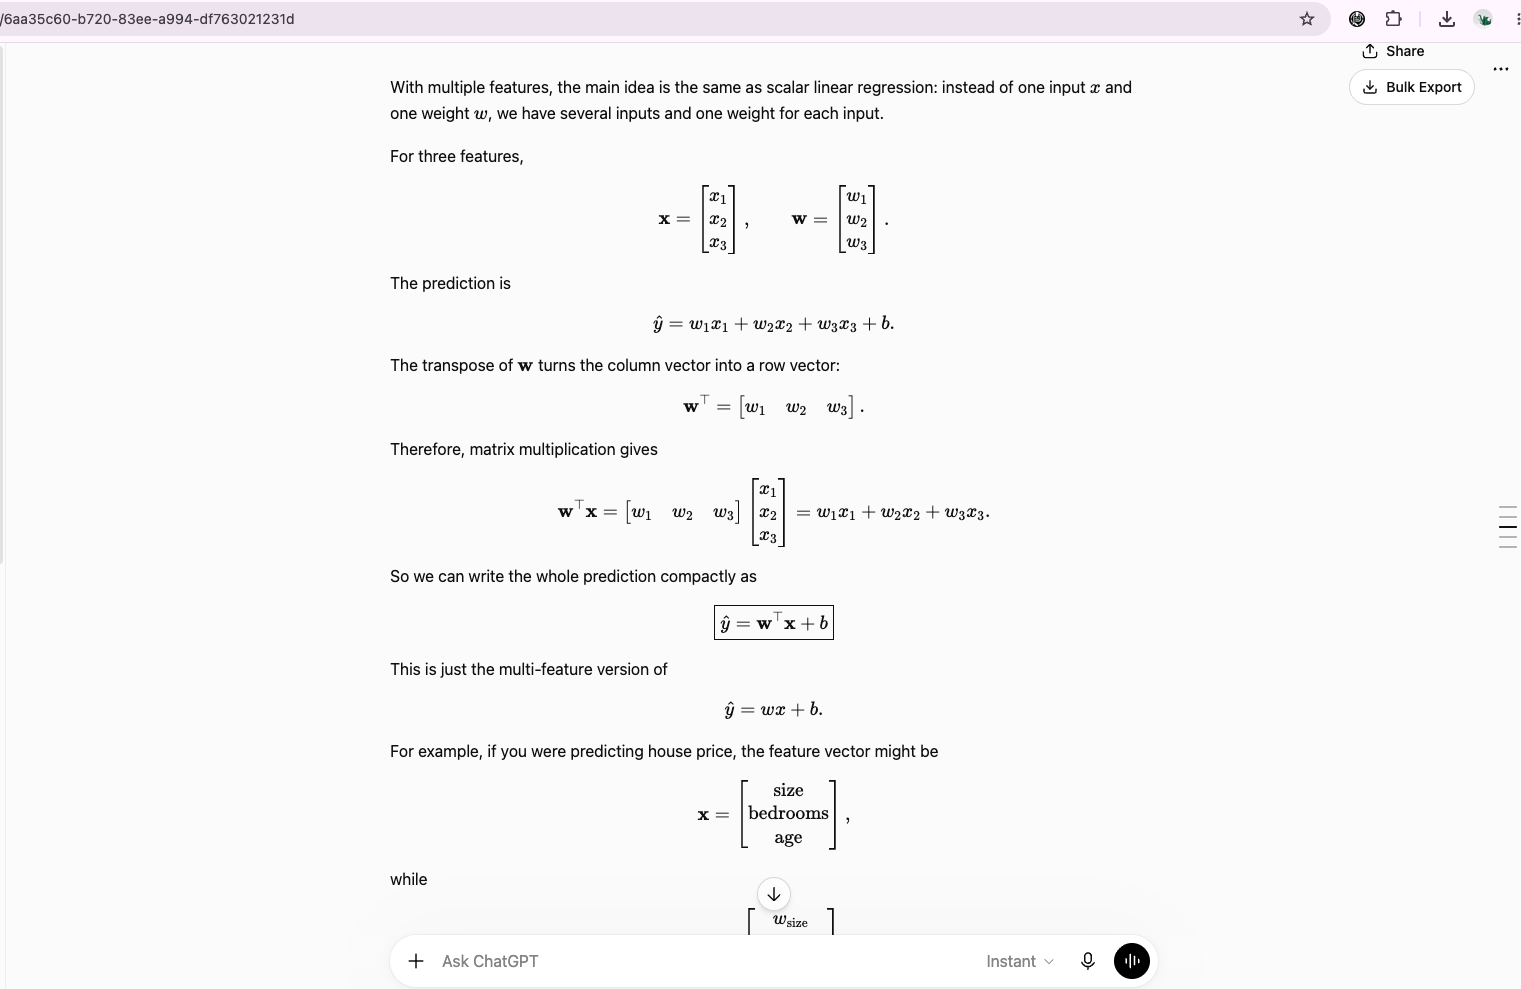
这是原始的 ChatGPT 回答:
这是导出后在 Obsidian 中打开的效果:
这对机器学习、线性代数、统计、数据科学和工程领域的对话尤其有用。
可以完整保留的常见 LaTeX 表达式
更新后的导出处理可以保留以下常见数学符号。
希腊字母
\alpha
\beta
\theta
\rho
\tau
\lambda
\nu
\epsilon
分数
\frac{a}{b}梯度
\nabla_{\theta}L(\theta)向量写法
\mathbf{w}^{\top}\mathbf{x}矩阵
\begin{bmatrix}
x_1 \\
x_2 \\
x_3
\end{bmatrix}
梯度下降
\theta_{t+1}
=
\theta_t
-
\eta\nabla_{\theta}L(\theta_t)
Softmax
P(y=i\mid\mathbf{x})
=
\frac{\exp(\mathbf{w}_i^\top\mathbf{x})}
{\sum_{j=1}^{K}\exp(\mathbf{w}_j^\top\mathbf{x})}
这些表达式能够以有效的 LaTeX 形式留在导出的 Markdown 中,不会在文本处理过程中被损坏。
代码中的反斜杠也会保持不变
这次更新还有一个重要部分。
技术类 ChatGPT 对话经常同时包含数学公式和程序代码。
例如:
newline_example = "hello\nworld"

tab_example = "column1\tcolumn2"

windows_path = r"C:\temp\new\beta\data.txt"

word_regex = r"\b[A-Za-z]+\b"
不能因为同一条对话中有 LaTeX,就随意修改这些反斜杠。
因此,新的处理逻辑不会对导出的正文执行通用的反斜杠解码。
这样可以同时保留:
- Python 转义序列
- 正则表达式
- Windows 文件路径
- Markdown 语法
- 代码示例
- LaTeX 命令
真实的技术对话很少只包含数学或只包含代码。大多数时候,两者会同时出现。
为什么这个问题比看上去复杂
乍看之下,保留 LaTeX 好像只是简单的文本替换。
实际上并不是。
例如,这个命令:
\nabla以 \n 开头。
这个命令:
\top以 \t 开头。
而下面的表达式:
\beta以 \b 开头。
这些前缀同时也是编程语言和序列化文本中常见的转义序列。
所以,最安全的办法不是反复对文本执行“反转义”。
当 ChatGPT 的 JSON 响应已经解析完成后,导出的字符串通常就应该被当作真实内容处理。
真正需要转换的,只有 ChatGPT 特有的数学分隔符。
这次更新采用的正是这种方式。
修复前与修复后
旧的导出流程可能让数学表达式变成原始文本或损坏的字符串,无法正常显示。
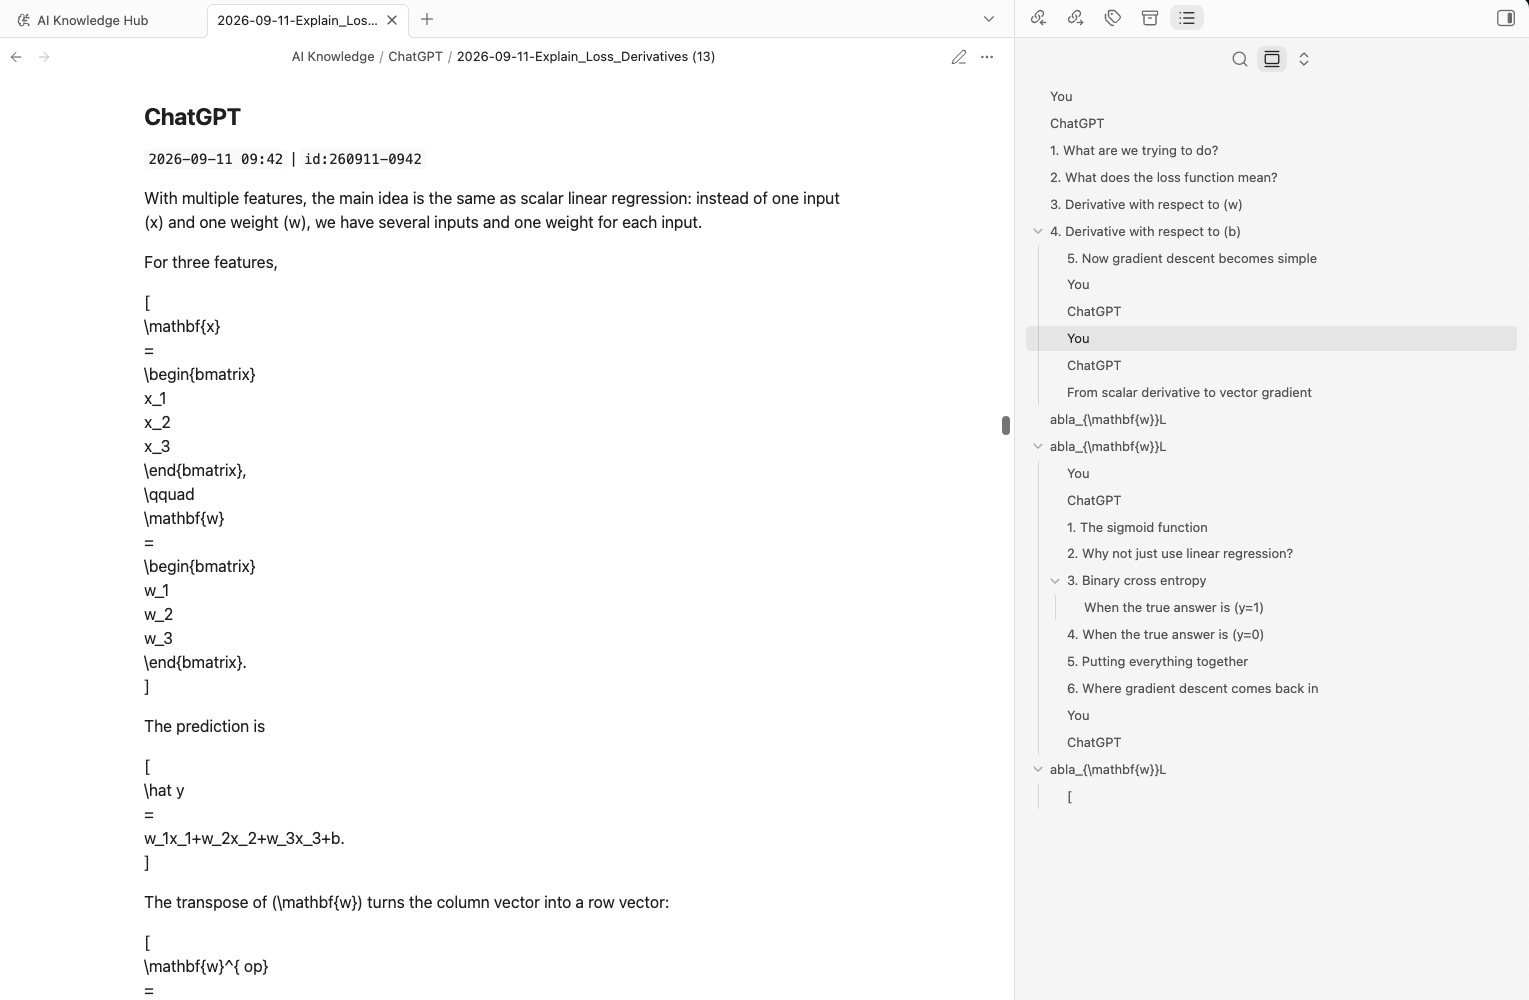
更新后,下载的 Markdown 会保留数学结构,并在 Obsidian 中正确渲染。
以下内容的差异尤其明显:
- 矩阵表示
- 梯度
- 多行公式
- 希腊字母
- 向量转置
- 较长的机器学习推导过程
观看完整导出流程
下面的短视频展示了从 ChatGPT 对话导出 Markdown,再到 Obsidian 中打开笔记的完整过程,其中也包括保留数学符号的效果。
把 ChatGPT 数学公式导出到 Obsidian 的步骤
不需要额外开启 LaTeX 模式。
正常的导出流程保持不变:
- 打开包含数学公式的 ChatGPT 对话。
- 使用 ChatGPT to Obsidian 导出对话。
- 下载 Markdown 文件。
- 把 Markdown 文件移动或保存到 Obsidian 知识库。
- 在 Obsidian 中打开笔记。
- 数学表达式会通过 Obsidian 内置的数学支持进行渲染。
同样的格式改进,也适用于扩展常规 Markdown 导出流程中的受支持内容。
关于 Custom Preview 中的公式显示
扩展还提供了一个 Custom Preview 页面,用于选择要导出的消息。
这个预览页主要用于内容筛选。
它可能会直接显示下面这样的 Markdown 数学分隔符,而不是把每一个公式都渲染出来:
$$
...
$$
这是正常现象。
真正重要的是下载后的 Markdown 文件。
只要在 Obsidian 中打开该文件,受支持的公式就会正常显示。
这样也可以避免为了预览页面再引入一套数学渲染库,让扩展保持轻量。
这项更新适合哪些人
如果你经常使用 ChatGPT 处理技术内容,这项更新会非常实用。
学生
保存数学、物理、统计、经济学和工程课程中的讨论,同时保留公式。
研究人员
把推导过程、方程、模型说明和技术讨论归档为本地 Markdown 笔记。
机器学习与数据科学用户
完整保留梯度、向量、矩阵、概率分布、损失函数、Softmax 和逻辑回归等表达式。
开发者
保存同时包含源代码、正则表达式、路径和数学符号的对话,避免一种格式破坏另一种格式。
使用 Obsidian 管理知识的用户
把技术类 ChatGPT 对话转成长期可读、可搜索、可复用的本地笔记。
为什么要保存为 Markdown
把 ChatGPT 对话导出到 Obsidian 的一个重要原因,是内容可以继续保持开放和可迁移。
Markdown 笔记可以:
- 搜索
- 建立双向链接
- 添加标签
- 建立索引
- 使用 Git 进行版本管理
- 备份
- 手工编辑
- 通过脚本处理
- 使用 Obsidian Properties
- 使用 Dataview 查询
- 使用 Obsidian Bases 整理
保留数学符号后,这套流程对技术知识管理会更有价值。
你保存的不再是一张公式截图,而是公式本身。
不只是 LaTeX 导出
ChatGPT to Obsidian 还支持:
- 导出当前 ChatGPT 对话
- 选择单条消息
- 选择性批量导出
- 批量备份对话
- ChatGPT Projects
- Group Chats
- Deep Research 对话
- ChatGPT 生成的图片
- 对话附件与生成文件
- ChatGPT Library 文件
- ChatGPT Images
- Archived Chats
- Obsidian 兼容的 YAML frontmatter
- 本地 Markdown 存储
LaTeX 更新延续了同一个目标:
把 ChatGPT 对话转移到自己的知识库时,尽可能保留有价值的原始结构。
体验 ChatGPT to Obsidian
如果你使用 ChatGPT 处理技术笔记、数学、研究、编程或学习内容,现在可以在导出时保留更多原始数学结构。
进一步了解:
目标很简单:
ChatGPT 对话离开 ChatGPT 之后,仍然应该保持完整和可读。
对于技术对话来说,这当然也包括其中的数学公式。